近日,浙江大学伊利诺伊大学厄巴纳香槟校区联合学院(ZJUI)副教授刘佐珠团队在前沿计算机技术赋能的口腔诊断和临床实践领域取得重要进展,推出了业内首个口腔临床多模态大模型DentVLM,相关成果A multimodal vision-language model for comprehensive dental diagnosis and enhanced clinical practice 发表于国际学术期刊《自然-通讯》(Nature Communications)。论文共同第一作者包括浙江大学2024级电子信息专业博士研究生孟子杰、浙江大学2025级电子信息专业硕士研究生代晞薇等,上海交通大学医学院附属第九人民医院博士郝晋、伊利诺伊大学厄巴纳香槟校区教授Jimeng Sun、浙江大学计算机科学与技术学院教授吴健、ZJUI副教授刘佐珠为共同通讯作者。
作为全球性公共卫生问题,口腔疾病影响了全球约35亿人,其诊治需求与医疗资源之间的缺口不断扩大,且在低收入和中等收入国家尤为突出。与此同时,口腔疾病诊断通常需要综合多源影像信息,传统人工阅片高度依赖专科经验,难以在基层医疗和大规模患者服务中同时保障效率与准确性。现有智慧诊疗系统则大多聚焦于单一影像模态或单项疾病,尚难满足真实诊疗场景中多模态、多任务、可交互的综合诊断需求。
针对这一问题,研究团队提出了面向口腔综合诊断的多模态视觉语言模型DentVLM。该模型能够统一处理口腔全景X线片、头颅侧位片以及五类口内照片共7种二维口腔影像模态,覆盖口腔疾病、既往治疗识别和错颌畸形等36项临床诊断任务。除诊断结论外,模型还能够以自然语言形式提供相应的临床依据和必要的解剖定位信息,从传统的单点识别工具拓展为可交互、便于临床复核的综合辅助诊疗系统。
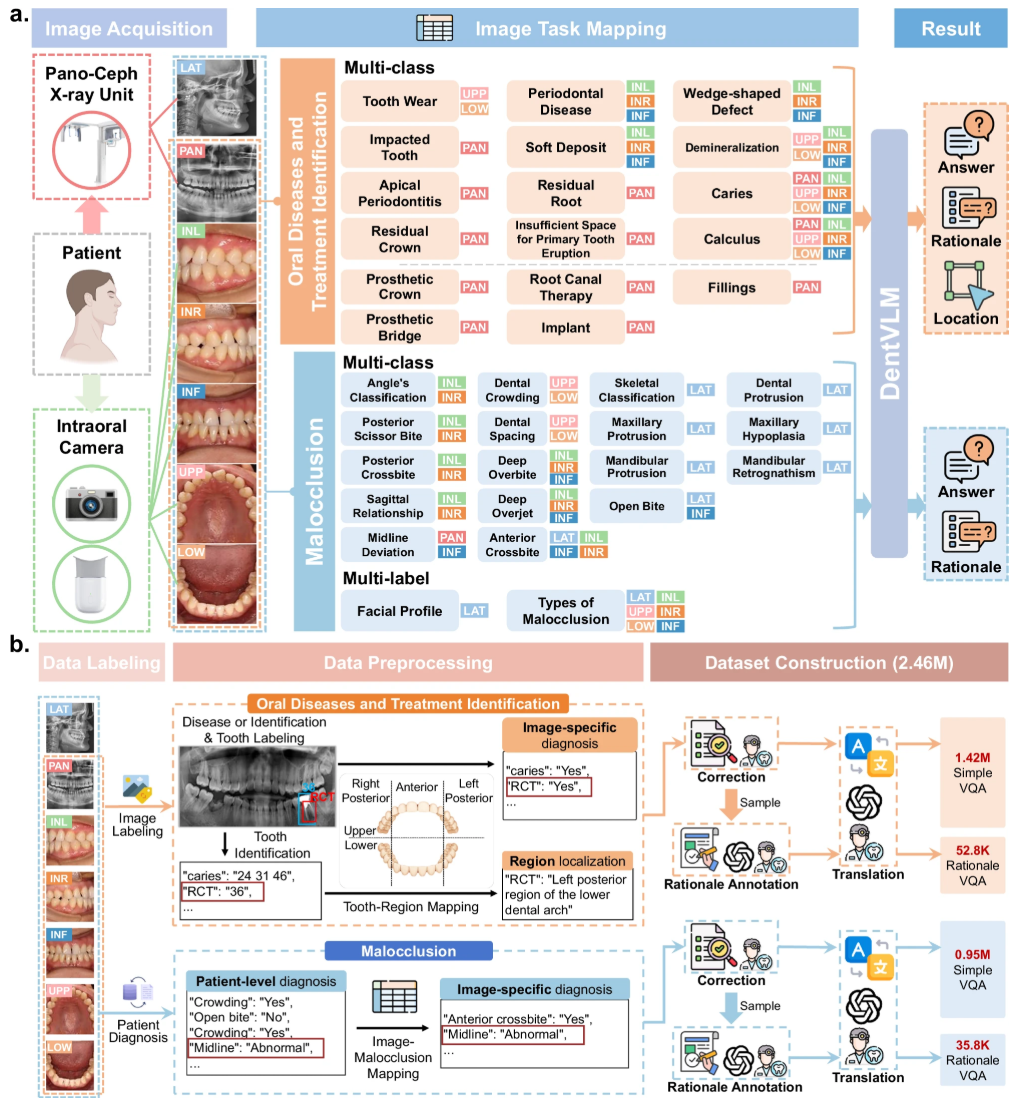
▲DentVLM的问题定义流程图
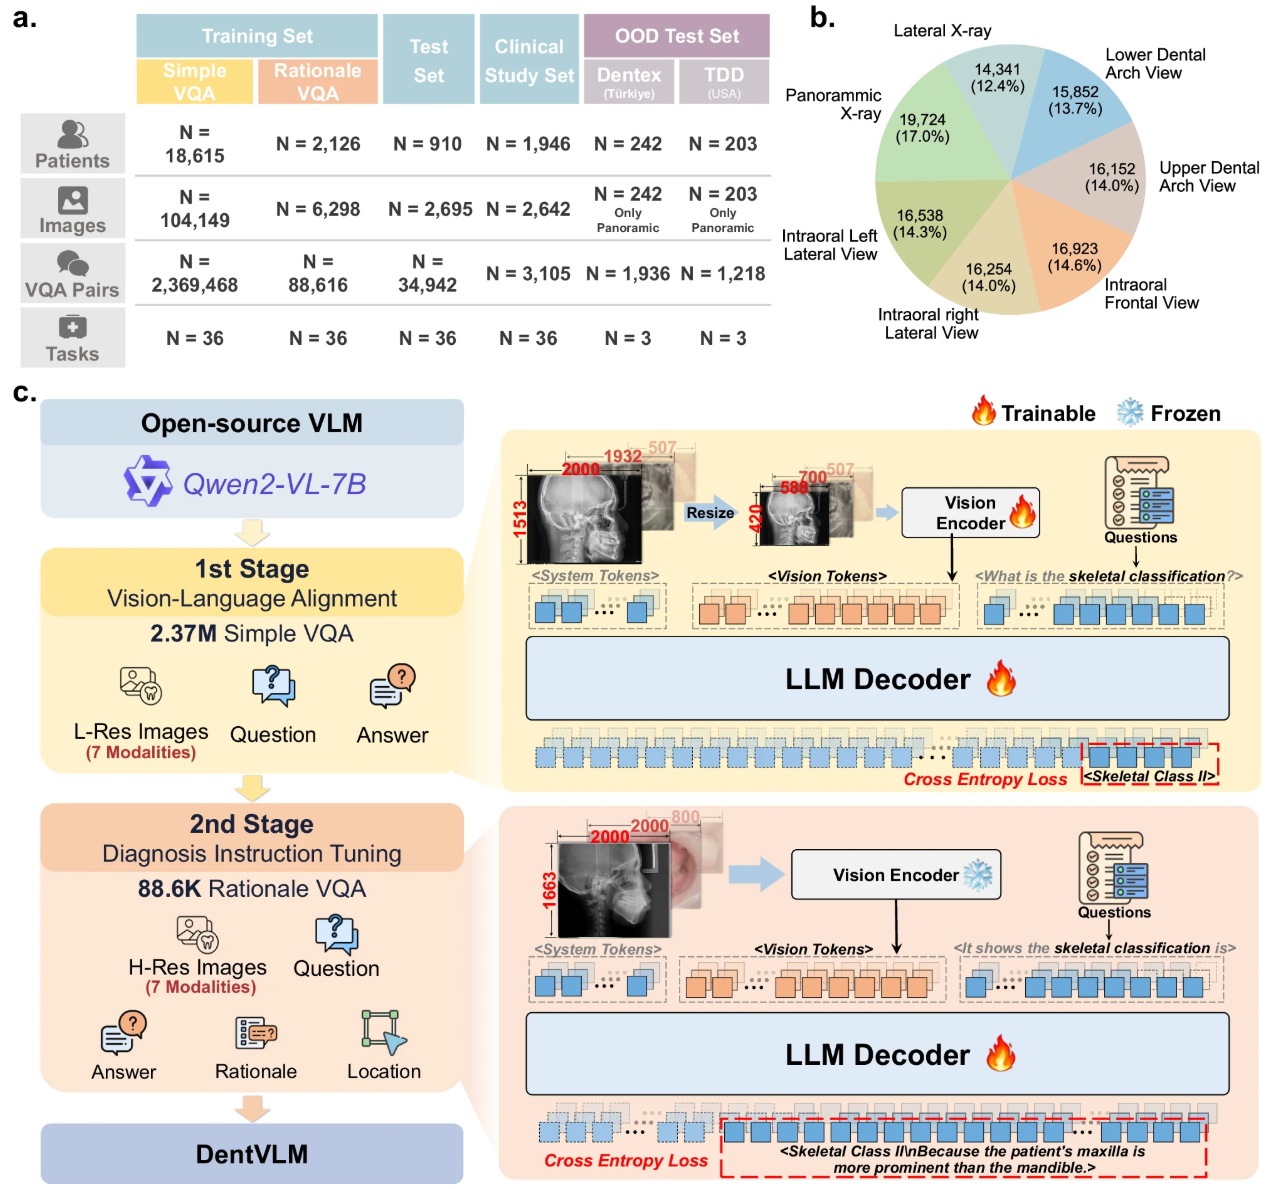
为提升模型对专业口腔医学知识和临床诊断逻辑的理解能力,研究团队基于2万多名患者的超过10万张口腔影像,构建了246万对中英文视觉问答数据。在此基础上,团队通过两阶段训练,逐步提升DentVLM在复杂口腔诊断任务中的准确性、可解释性和临床可用性。
在与18个通用及医学口腔专用多模态模型的对比实验中,DentVLM相较主要先进基线模型平均提升23.8%。模型在一般口腔疾病及治疗识别、错颌畸形判断以及病变区域定位等任务中均表现出较好的综合性能,体现出其在多模态口腔医学理解方面的优势。
▲DentVLM与代表性多模态模型在不同口腔诊断任务中的性能对比
研究团队进一步开展多中心临床读片实验,共纳入32名不同经验层级参与者。结果显示,DentVLM总体诊断能力与中年资口腔医生相近。在模型辅助下,低年资医生总体诊断准确率提高 10.5%,不同年资医生的诊断时间缩短约15.0%—37.0%。相关结果表明,DentVLM不仅能够独立完成多类口腔影像分析任务,还具有作为智能辅助工具提升临床诊疗效率、辅助年轻医生决策的应用潜力。
该研究推动智慧口腔诊疗由传统的“单一影像—单一任务”识别模式向多模态、多任务、可解释的综合辅助诊断模式拓展,为家庭口腔健康筛查、医院智能辅助诊断以及基层口腔医疗等场景提供了新的技术路径。目前,该研究相关成果已应用于国内多家医疗机构。团队正加速研发面向口腔通用智能的第二代多模态基础模型,以支持更多模态、更复杂任务、更自然交互。
该论文发表于Nature Communications, vol. 17, Art. no. 8933, July 2026, doi: 10.1038/s41467-026-75718-x。
论文链接:https://www.nature.com/articles/s41467-026-75718-x
《自然-通讯》(Nature Communications)是Nature Portfolio旗下于2010年创刊的多学科开放获取期刊。期刊覆盖生物、物理、化学、地球、健康及工程等九大学科领域,致力于发表对各领域专家有重要意义的高质量研究进展。作为完全开放获取期刊,其2025年影响因子为18.1。